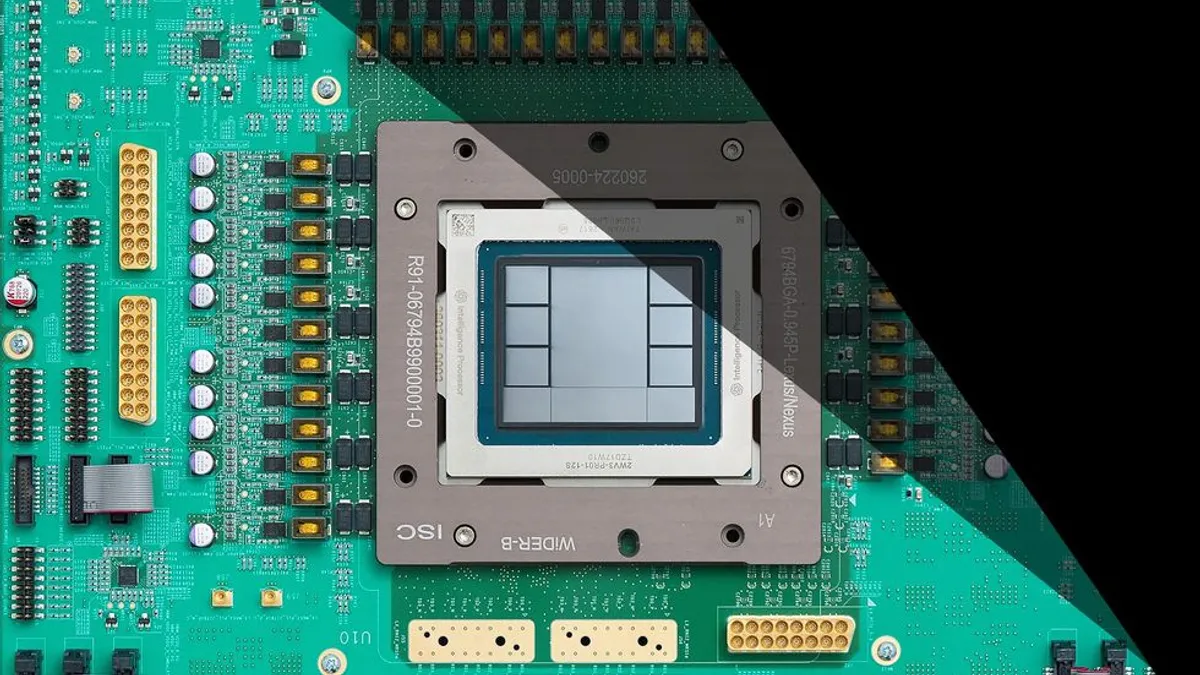
OpenAI julkisti Jalapeño-tekoälykiihdyttimen, joka suunniteltiin yhtiön omien kielimallien avulla alle 20 kuukaudessa. Piiri lupaa 3,6 kertaa paremman suorituskyvyn kuin Nvidian GB300.
Tekoälyyhtiö OpenAI on julkistanut ensimmäisen oman tekoälykiihdytinpiirinsä, joka kantaa nimeä Jalapeño. Yhtiön mukaan piiri tarjoaa 13,4 petaflopsin laskentatehon 4-bittisellä tarkkuudella ja hyödyntää 232 gigatavua kehittynyttä muistia 15,4 teratavun sekuntinopeudella. OpenAI:n julkaisemissa vertailutesteissä Jalapeño pienentää päättelyn kokonaislatenssia – aikaa kehotteesta viimeiseen tuotettuun tokeniin – jopa 3,6-kertaisesti verrattuna Nvidian GB300-piiriin, jota yhtiö nykyisin käyttää. Tämän lisäksi Jalapeño saavuttaa suorituskykynsä pienemmällä virrankulutuksella.
Piirin suorituskykyäkin merkittävämpi uutinen on sen suunnitteluprosessi, jota nopeutettiin merkittävästi OpenAI:n omien suurten kielimallien avulla. Koko projekti eteni ensimmäisestä arkkitehtuurikonseptista toimivaan piisiruun alle 20 kuukaudessa. Aikaa piirin logiikan määrittelevän rekisterisiirtotason (RTL) koodin valmistumisesta valmistusvaiheeseen (tapeout) kului vain yhdeksän kuukautta. Vaikka aikataulu on nykymittapuullakin nopea, asiantuntijat uskovat sen näyttävän hitaalta tulevaisuudessa kielimallien kehittyessä ja integroituessa syvemmin piirisuunnittelun työkaluihin.
OpenAI toteutti projektin poikkeuksellisen pienellä, keskimäärin alle 100 hengen tiimillä. Yhtiön kumppanina toimi Broadcom, joka vastasi piirin fyysisestä suunnittelusta ja valmistuksesta. OpenAI:n tiimi keskittyi kokonaisjärjestelmän, mukaan lukien kiihdyttimen arkkitehtuurin, muistihierarkian ja verkkoyhteyksien, suunnitteluun. OpenAI:n laitteistokehityksestä vastaavan johtajan Richard Hon mukaan kielimallit antavat insinööreille "supervoimia", joiden avulla he voivat tutkia useampia suunnitteluvaihtoehtoja huomattavasti aiempaa nopeammin.
Menetelmän ytimessä oli korkean tason synteesi (HLS), joka mahdollistaa piirien suunnittelun perinteisiä laitteistokuvauskieliä abstraktimmilla ohjelmointikielillä. OpenAI hyödynsi Googlen alun perin kehittämää avoimen lähdekoodin XLS-työkaluketjua, jonka avulla insinöörit saattoivat kirjoittaa koodia C++:lla ja Rust-kielestä inspiroituneella DSLX-kielellä. Koska nämä kielet muistuttavat enemmän perinteistä ohjelmointia, OpenAI:n kielimallit pystyivät avustamaan suunnittelussa tehokkaammin. XLS-työkalu muunsi tämän koodin valmistuksessa käytettäväksi Verilog-laitteistokuvauskieleksi.
Projektin aikana myös käytetyt tekoälymallit kehittyivät. Alussa tiimi hyödynsi o3-tason malleja, mutta projektin loppuvaiheessa käytössä oli jo syyskuussa 2026 julkaistun GPT-6 Astran edeltäjiä. Uusimmat mallit pystyvät työskentelemään jo suoraan Verilog-kielellä, mikä vähentää HLS-työkalujen tarvetta. Tekoäly osoitti tehonsa myös ohjelmisto-optimoinnissa: kun ensimmäiset piirit saapuivat tehtaalta, sisäiset mallit optimoivat testiohjelmiston suorituskyvyn noin 40 tunnissa 0,31 prosentista 88,94 prosenttiin teoreettisesta maksimista.
Vaikka tekoälyavusteisuus painottui suunnittelun alkuvaiheeseen (front-end), sitä hyödynnettiin myös fyysisessä suunnittelussa (back-end). OpenAI:n mukaan tekoälyohjattu optimointi auttoi pienentämään matriisikertolaskuyksiköiden vaatimaa piipinta-alaa 10 prosentilla ihmisoptimoituun perustasoon verrattuna. OpenAI:n tiimi uskoo, että tulevaisuudessa tekoäly integroidaan entistä syvemmälle koko suunnitteluprosessiin, erityisesti verifiointiin ja fyysiseen suunnitteluun. Tavoitteena ei ole täysin automatisoitu piirisuunnittelu, vaan insinöörien työn tehostaminen, mikä mahdollistaa pienten tiimien saavuttaa huippuluokan tuloksia nopeilla aikatauluilla.
Tärkeimmät pointit
- Suorituskyky: 13,4 petaflopsia (4-bit), 232 Gt muistia, 15,4 Tt/s muistikaista.
- Kehitysaika: Alle 20 kuukautta konseptista piiriksi, 9 kuukautta RTL-koodista valmistukseen.
- Vertailu: Jopa 3,6-kertainen parannus latenssiin verrattuna Nvidia GB300 -piiriin.
- Suunnittelumetodi: Hyödynsi korkean tason synteesiä (HLS) ja OpenAI:n omia kielimalleja.
- Kumppani: Broadcom vastasi piirin fyysisestä suunnittelusta ja valmistuksesta.
- Ohjelmisto-optimointi: Tekoäly nosti suorituskyvyn 0,31 %:sta 88,94 %:iin 40 tunnissa.
- Käytetyt mallit: Kehityksessä käytettiin o3-mallista GPT-6 Astran edeltäjiin.
- Fyysinen optimointi: Tekoäly pienensi matriisikertolaskuyksiköiden pinta-alaa 10 %.
Lähde: IEEE Spectrum – AI — alkuperäinen artikkeli julkaistu 14.9.2026